
SRE escrevendo sobre cloud, infraestrutura e a arte de construir sistemas confiáveis.
Database - Shrink de Storage no Amazon RDS com Blue/Green Deployments
O Amazon RDS não permite reduzir o storage alocado diretamente em uma instância existente. Para diminuí-lo, é necessário migrar para uma configuração menor — e o Blue/Green Deployments permite fazer isso de forma gerenciada, com baixo downtime.
Este artigo explica o processo, passo a passo: medir a oportunidade, dimensionar o alvo, fazer a troca e automatizar com verificações.
O Problema: o Ratchet Effect do Storage
No RDS, o storage só cresce. Dá para aumentar a qualquer momento, mas não reduzir.
Esse comportamento tem nome: ratchet effect. Cada aumento, por incidente ou por pico, vira permanente.
Imagine alugar um galpão inteiro para guardar uma mudança: as caixas vão embora, mas o aluguel continua. Antes do Blue/Green, devolver o galpão exigia migração manual, com cutover na mão: demorado, sujeito a erros e difícil de escalar.
Medindo a Oportunidade
Para cada instância, colete três informações:
FreeStorageSpacedo CloudWatch: quanto está livre;- storage alocado: quanto está sendo pago;
- storage autoscaling: se está ligado e qual é o teto (
MaxAllocatedStorage).
Com isso, ordene os databases por ocupação:
Por exemplo, uma instância com 1.000 GiB alocados e 870 GiB livres tem 13% de ocupação.
Um bom ponto de partida para a linha de corte: ocupação abaixo de 25% e mais de 50 GiB alocados.
As Opções
| Opção | Downtime | Para muitas instâncias |
|---|---|---|
| Não fazer nada e aguardar o crescimento ocupar o storage | nenhum | o storage ocioso continua sendo pago até ser usado |
| Restaurar snapshot numa instância menor | não se aplica | não funciona: o RDS não restaura snapshot com storage menor que o original |
Migração manual (pg_dump/mysqldump, AWS DMS, replicação nativa) | janela longa, cutover na mão | muita coordenação e risco por database |
| Blue/Green com shrink | troca curta | gerenciado pela AWS e automatizável via API |
O Blue/Green atende aos dois requisitos: troca curta, mesmo endpoint e tudo via API.
Blue/Green no Amazon RDS
A AWS cria uma cópia da produção (green) e a mantém sincronizada por replicação. No switchover, o green assume o nome e o endpoint do blue, e o antigo vira -old1.
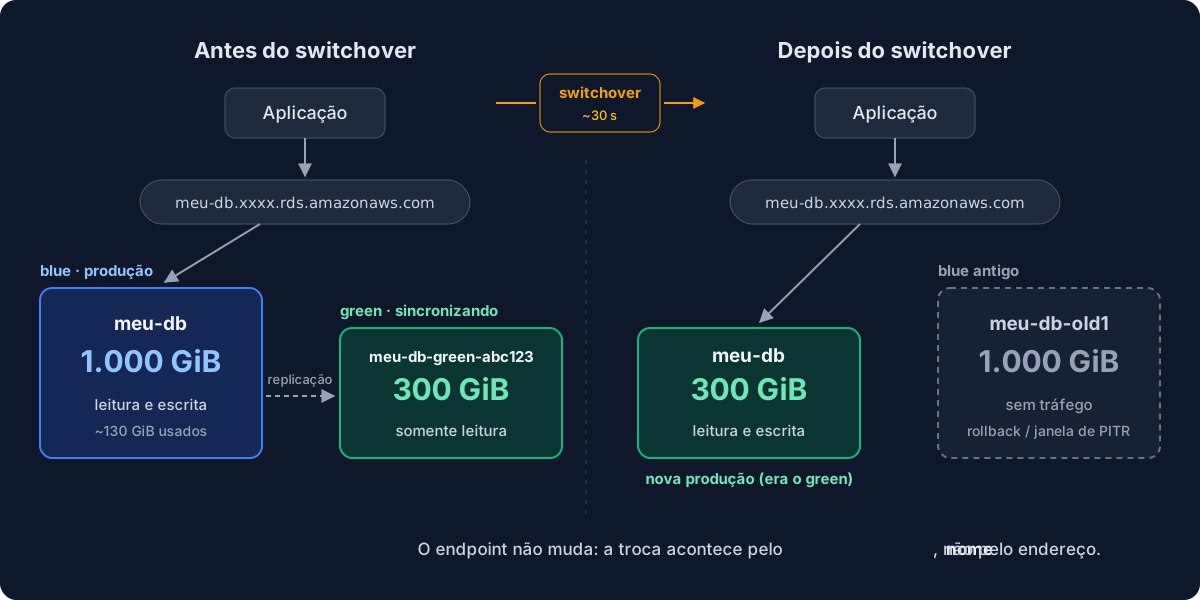
Desde novembro de 2024, o green pode nascer com storage menor (PostgreSQL 12+, MySQL 5.7+, MariaDB 10.4+). É isso que torna o processo possível.
Replicação
O green fica sincronizado via binlog no MySQL e no MariaDB, e via WAL no PostgreSQL (a replicação física), em que o green reaplica o log de alterações. Para o shrink, use a replicação física, sem upgrade junto. No PostgreSQL também existe a replicação lógica, usada em upgrade major, mas ela tem restrições com DDL, large objects e tabelas sem primary key.
Anatomia do Switchover
No switchover, o RDS:
- Roda os guardrails, verificando se os dois ambientes estão prontos.
- Bloqueia as escritas e derruba as conexões nos dois ambientes.
- Espera a replicação alcançar o blue.
- Renomeia instâncias e endpoints: o green assume o nome do blue.
- Libera as escritas na nova produção.
A escrita fica parada entre os passos 2 e 5, por isso não há perda de dados na troca.
Se as condições não forem atendidas dentro do timeout (padrão de 300 s), o switchover é abortado e nada muda.
O Processo
Dimensionando o Storage Alvo
Uma regra simples: 2× o storage usado, arredondado para cima em múltiplos de 50 GiB, com autoscaling ligado. Exemplo: 130 GiB usados → 260 → 300 GiB. O fator 2 deixa folga, e o autoscaling cresce se precisar.
Por que Automatizar
Para um database, o Blue/Green é simples. Para muitos, o processo manual vira o problema:
- Muitos passos: elegibilidade, alvo, criação, cópia, troca, restart e limpeza, multiplicados por cada database.
- Suscetível a erro: alvo errado, lag alto no switchover ou restart esquecido.
- Sem rastreabilidade: na mão, não fica registro. Numa orquestração, os dados de cada execução ficam auditáveis.
A Orquestração
Cada execução recebe o nome do RDS, o storage alvo e o ambiente, e dá para disparar uma ou várias em paralelo.
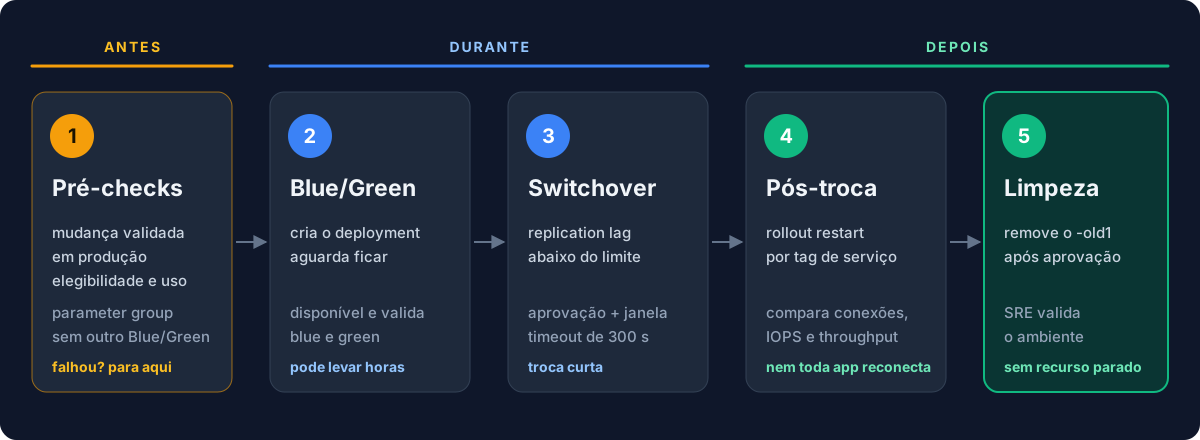
- Validação da mudança: em produção, só segue com a mudança aprovada.
- Pré-checks em paralelo: resolve o RDS pelo nome e valida elegibilidade, uso real de storage, se não há outro Blue/Green em andamento e se o parameter group está sincronizado e com os parâmetros necessários. Se algo falha, para aqui.
- Blue/Green: cria o deployment, aguarda ficar disponível e valida as instâncias blue e green.
- Switchover: depois da aprovação, só troca com replication lag abaixo de um limite definido (por exemplo, 60 s).
- Pós-troca: faz o rollout restart dos serviços e compara replication lag, pool de conexões, IOPS e throughput com o estado anterior.
- Limpeza: remove o
-old1só com aprovação manual, depois de validar o ambiente.
Essas etapas valem para qualquer operação suportada pelo RDS Blue/Green, como upgrades de versão e scaling.
Pontos de Atenção
- Limites de instâncias por AZ e arquitetura (ARM). Cada Blue/Green cria instâncias extras. Confira limites e disponibilidade antes de cada lote.
- Engines e versões suportadas. Só PostgreSQL 12+, MySQL 5.7+ e MariaDB 10.4+.
- Uso baixo com mais de 400 GiB alocados. No gp3, a partir de 400 GiB a baseline é de 12.000 IOPS; abaixo, cai para 3.000 IOPS. Pode ter sido dimensionado por IOPS: avalie
ReadIOPSeWriteIOPS. - Melhor horário para cada produto. A escrita para na troca: combine a janela com o time.
- Custo com o Blue/Green ativo. Green e blue são cobrados juntos enquanto o deployment existir, e o
-old1até ser apagado. - Reconexão das aplicações. Nem toda aplicação tem reconexão automática configurada: planeje um rollout restart depois da troca.
- Queries lentas no MySQL. O database novo pode assumir com estatísticas desatualizadas: rode o
ANALYZE TABLEdepois da troca. - Drift no Terraform. O state do RDS não muda; só o storage alocado diverge do valor declarado no código. Uma saída é ler o storage atual com um
datano módulo.
A Execução
Trabalhe em lotes pequenos, para limitar o impacto. Crie os Blue/Green com antecedência, porque a cópia do shrink leva horas. Faça os switchovers um database por vez, na janela combinada, acompanhando a performance antes e depois.
O fluxo cabe em quatro comandos:
# 1. Cria o green com storage menor
aws rds create-blue-green-deployment \
  --blue-green-deployment-name meu-db-shrink \
  --source arn:aws:rds:us-east-1:123456789012:db:meu-db \
  --target-allocated-storage 300

# 2. Acompanha o progresso do shrink no green
aws rds describe-db-instances \
  --db-instance-identifier meu-db-green-abc123 \
  --query 'DBInstances[0].[DBInstanceStatus,PercentProgress]'

# 3. Faz a troca
aws rds switchover-blue-green-deployment \
  --blue-green-deployment-identifier bgd-xxxxxxxxxxxx \
  --switchover-timeout 300

# 4. Remove o deployment (a nova produção e o -old1 continuam existindo)
aws rds delete-blue-green-deployment \
  --blue-green-deployment-identifier bgd-xxxxxxxxxxxx
Conclusão
O Amazon RDS Blue/Green Deployments resolve o que antes exigia migração manual: reduzir o storage com uma troca curta e segura. Com uma orquestração que verifica antes, durante e depois, isso vira um processo repetível.
Se seus databases só crescem, comece comparando o alocado com o usado.
Revisores
Referências
- Amazon RDS Blue/Green Deployments support storage volume shrink - AWS What’s New, nov. 2024
- Shrink storage volumes for your RDS databases and optimize your infrastructure costs - AWS Database Blog
- Overview of Amazon RDS Blue/Green Deployments - Amazon RDS User Guide
- Switching a blue/green deployment in Amazon RDS - Amazon RDS User Guide
- Limitations and considerations for Amazon RDS blue/green deployments - Amazon RDS User Guide
- Amazon RDS DB instance storage - Amazon RDS User Guide
SRE escrevendo sobre cloud, infraestrutura e a arte de construir sistemas confiáveis.